



Las redes empresariales crecen y se vuelven más complejas cada año. Ante este escenario, los equipos de TI deben monitorear y analizar constantemente la gran cantidad de datos que generan los servicios en la nube, entornos híbridos y multicloud, dispositivos IoT y aplicaciones críticas, en flujos de procesamiento lentos y costosos.
El AI Readiness Index 2025 de Cisco registró que más del 54% de las organizaciones reporta que sus redes no pueden escalar ante el volumen y la complejidad de datos que exige la inteligencia artificial.
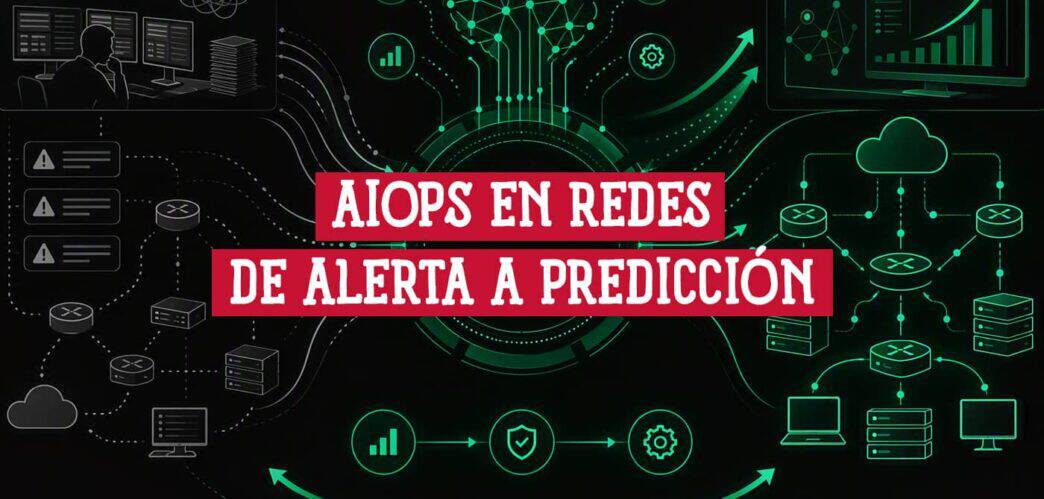
Pero AIOps está transformando la forma en que los equipos de infraestructura y NetOps monitorean, diagnostican y responden a los problemas de red, al combinar inteligencia artificial, aprendizaje automático, analítica y automatización, para pasar de una gestión reactiva a un modelo más predictivo y automatizado.
IBM define AIOps como el uso de inteligencia artificial, aprendizaje automático y procesamiento de lenguaje natural para automatizar y optimizar las operaciones de TI. AIOps no se limita a las redes: es un enfoque que abarca las operaciones de TI en general. Estas plataformas pueden recopilar datos de múltiples fuentes, identificar patrones, correlacionar eventos y ayudar a determinar las causas raíz de incidentes.
Del monitoreo tradicional a las operaciones inteligentes

La gestión de redes mediante dashboards, sistemas de monitoreo, logs y alertas configuradas ha sido lo tradicional durante años, pero el crecimiento de la infraestructura ha incrementado la cantidad de información que los equipos deben procesar, lo cual ha hecho todo este proceso más complejo.
En este caso, AIOps llega con una capa de inteligencia capaz de analizar simultáneamente diferentes fuentes de información: métricas de rendimiento, logs, eventos, datos de dispositivos, tráfico de red, tickets e información histórica.
El objetivo no es generar más alertas, sino determinar cuáles requieren atención y establecer relaciones entre eventos aparentemente independientes.
Por ejemplo, si se presenta una caída en el rendimiento de una aplicación, AIOps puede señalar si el origen está en una modificación en un dispositivo de red, en un incremento inesperado del tráfico o en una falla en otro componente de la infraestructura.
Gracias a la IA, estos sistemas pueden correlacionar estas señales para ayudar a identificar la causa raíz y recomendar una respuesta.
Google Cloud señala que AIOps puede analizar grandes volúmenes de datos, detectar anomalías, identificar causas de problemas y ayudar a anticipar incidentes antes de que ocurran.
IA para redes: del diagnóstico a la predicción
Uno de los grandes beneficios de la implementación de IA en redes es la capacidad de detectar patrones que pueden pasar desapercibidos para los métodos tradicionales.
Los algoritmos de aprendizaje automático pueden crear líneas base sobre el comportamiento normal de una red para detectar desviaciones más rápidamente. Así pueden identificarse anomalías relacionadas con la latencia, disponibilidad, utilización de recursos o comportamiento de determinados dispositivos.
Con los modelos de mantenimiento predictivo de redes, el objetivo deja de ser únicamente reaccionar ante una interrupción y pasa a ser anticipar condiciones que podrían provocar degradación del servicio.
Automatización de la respuesta
La automatización es uno de los aportes clave de la implementación de IA en la gestión de redes, ya que permite conectar distintas etapas del flujo operativo: detectar alertas, analizar logs, identificar los dispositivos afectados, crear tickets y ejecutar acciones de corrección.
Cisco describe casos en los que un sistema de gestión de red con capacidades de AI/ML puede detectar un problema, diagnosticarlo y recomendar una acción, además de publicar los eventos de la red en un sistema ITSM como ServiceNow para su seguimiento.
Pero esto no significa que todas las decisiones deban ser delegadas a la IA, ya que en redes críticas, las empresas deben definir sus propias políticas, permisos y niveles de aprobación para determinar qué acciones puede ejecutar automáticamente el sistema y cuáles requieren intervención humana.
Este enfoque gana importancia a medida que se implementan más agentes de IA, capaces de investigar problemas y ejecutar acciones sobre la infraestructura.
Cisco, por ejemplo, ha presentado arquitecturas en las que agentes especializados pueden abordar tareas como troubleshooting, problemas de rendimiento y desviaciones de configuración.
Cómo abordar la implementación de IA en redes
El primer paso para la implementación de IA en redes es identificar procesos donde exista un problema operativo concreto y donde los datos disponibles permitan generar valor.
Las compañías pueden comenzar con estas tres primeras etapas:
1. Priorización de casos de uso Algunos de los escenarios más importantes a evaluar son la detección de anomalías, correlación de eventos, análisis de causa raíz, predicción de fallas y automatización de tareas repetitivas.
2. Consolidación de datos Una vez identificado el caso de uso, la IA necesita información coherente y confiable. Esto significa que datos como logs, métricas, eventos, configuraciones y datos de rendimiento deben estar disponibles y correctamente integrados.
3. Incorporar automatización progresivamente La automatización se puede adoptar de forma progresiva a medida que el equipo comprende sus capacidades y adquiere mayor capacitación y confianza en la IA. Conviene empezar por acciones de bajo riesgo, sujetas a políticas y controles definidos.

Hay algo que deben tener claro las compañías y es que la calidad de los datos es esencial para que AIOps funcione y dé los resultados esperados. El mismo informe registró que el 64% de las organizaciones tiene dificultades para centralizar sus datos, una barrera directa para alimentar cualquier sistema de inteligencia artificial.
Gobernanza: quién accede, quién ejecuta y quién revierte
La gobernanza adquiere más importancia todavía cuando la IA pasa de analizar información a ejecutar acciones.
Por esto, es clave que las compañías definan quién puede acceder a los datos, qué acciones puede realizar un sistema automatizado, cómo se registran las decisiones y qué mecanismos existen para detener o revertir una acción.
El AI Risk Management Framework (AI RMF) del NIST propone cuatro funciones para gestionar los riesgos asociados con sistemas de inteligencia artificial: gobernar, mapear, medir y gestionar. Aunque el framework no está diseñado exclusivamente para redes, sus principios pueden servir como referencia para establecer prácticas de IA confiable.
En infraestructura crítica, esta consideración es todavía más relevante: una automatización incorrecta puede afectar disponibilidad, seguridad y continuidad operativa.
Hacia redes más predictivas y autónomas
AIOps conecta tres capacidades que tradicionalmente se gestionaban por separado: observabilidad, inteligencia y automatización, lo que representa una evolución importante en cuanto a la gestión de redes.
La tendencia apunta hacia operaciones capaces de detectar anomalías, comprender el contexto de un incidente, identificar su causa, recomendar una respuesta y, cuando las políticas lo permitan, ejecutar acciones automáticamente.
El desafío para las organizaciones no es solo implementar IA, sino lograr que esta integración se haga correctamente con los datos, procesos, herramientas y controles que ya forman parte de su infraestructura.
AIOps no sustituye a los equipos de redes: les quita el tiempo que hoy dedican a revisar manualmente grandes volúmenes de señales y se lo devuelve para diseñar, optimizar y gobernar la infraestructura.